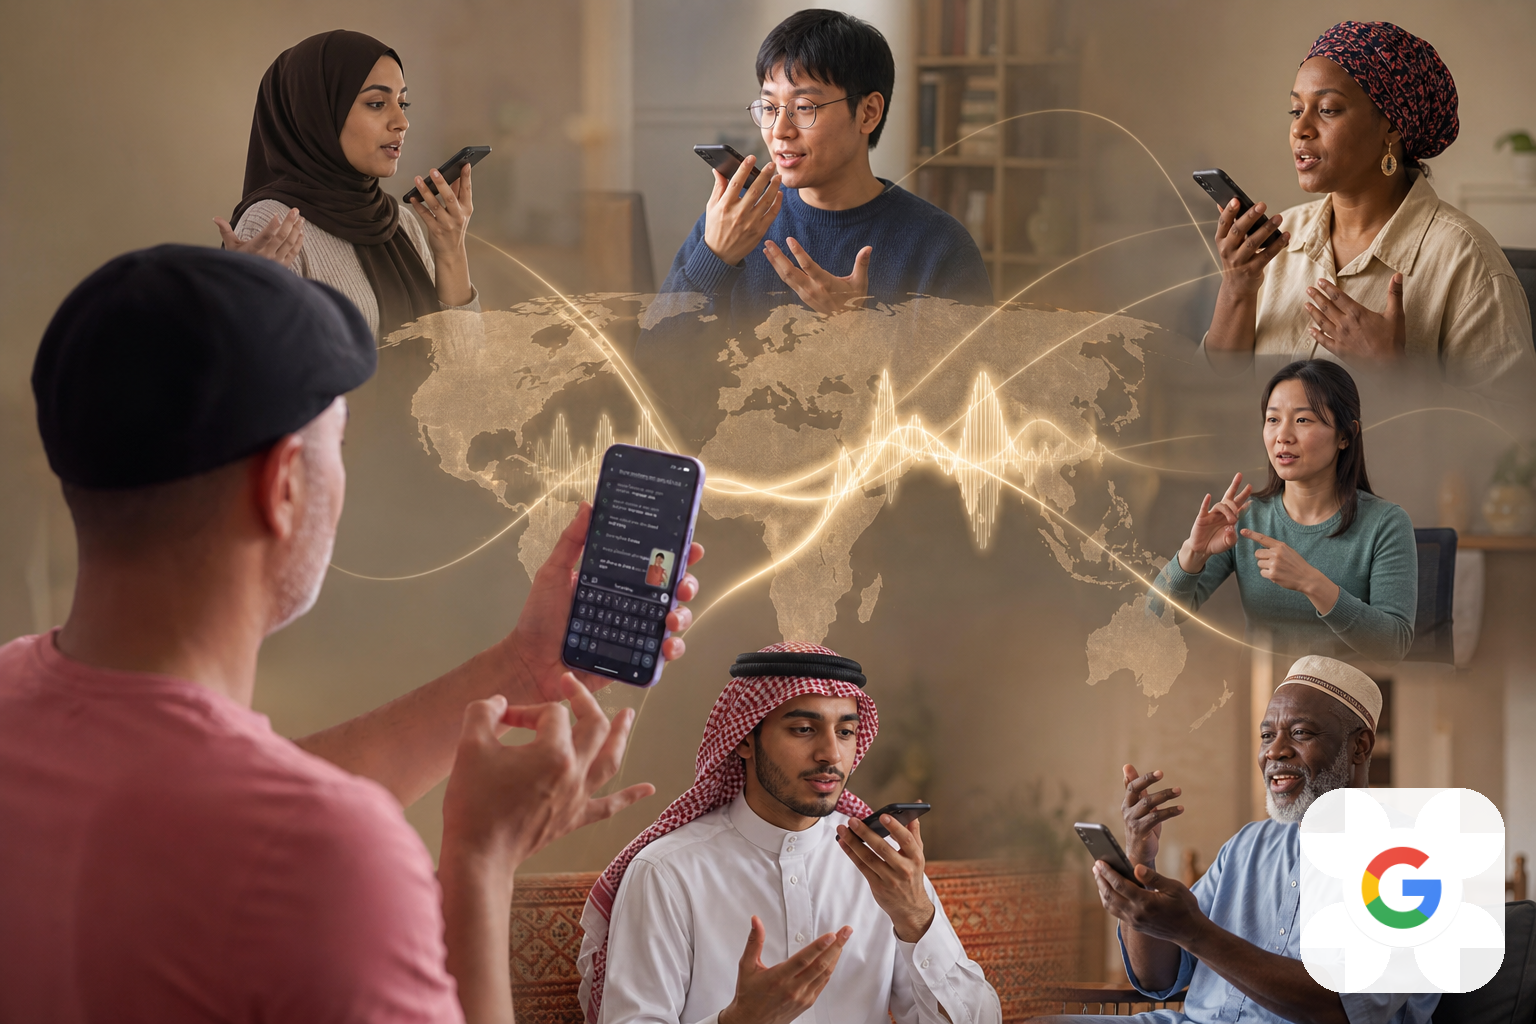
أعلنت غوغل في 15 سبتمبر 2026 توجّهًا جديدًا في تقنيات اللغة يعتمد على تدريب نماذج الذكاء الاصطناعي لفهم الكلام كما يُستخدم في الحياة اليومية، لا كما يظهر في نصوص مكتوبة ومنظمة. ويأتي ذلك ضمن مسار أوسع لتقليل الفجوة بين اللغات واسعة الانتشار واللغات واللهجات التي لا تحظى ببيانات رقمية كافية.
تفاصيل الخبر
وتقول الشركة إن تقنياتها اللغوية تُستخدم حاليًا في أكثر من 300 لغة، بينما يدعم مترجم غوغل أكثر من 250 لغة. لكن هذا الانتشار لا يعني أن الأداء متساوٍ بينها جميعًا، إذ ما تزال آلاف اللغات الحية واللهجات محدودة الحضور في محركات البحث وخدمات الإملاء والترجمة والمساعدات الصوتية.
أحد محاور التطوير يتمثل في الانتقال من أنظمة معالجة الصوت على مراحل منفصلة إلى نماذج قادرة على تحليل التسجيل الصوتي مباشرة. ووفق العرض المعلن، يتيح هذا النهج التقاط عناصر غالبًا ما تضيع عند تحويل الكلام إلى نص أولًا، مثل الترددات، والتوقفات، وتداخل الأصوات، والانفعالات، والانتقال بين لغتين داخل المحادثة الواحدة.
وتتضمن التطبيقات التي أشارت إليها غوغل أدوات للترجمة الصوتية الفورية عبر عشرات اللغات، إلى جانب نماذج لتحويل الكلام إلى نص منسق حتى في البيئات الصاخبة أو عند استخدام مصطلحات متخصصة. كما يمكن لبعض هذه الأدوات إزالة كلمات الحشو وتحسين علامات الترقيم وتعديل النص عبر أوامر صوتية، مع دعم التبديل بين اللغات أثناء الحديث.
ولا تقتصر الخطة على تحسين المنتجات الحالية؛ إذ تستهدف مبادرة اللغات الألف دعم أكثر اللغات استخدامًا حول العالم. وتعتمد الشركة في ذلك على نموذج صوتي دُرّب على 12 مليون ساعة من التسجيلات، مع استخدام التعلم العابر للغات لنقل الأنماط المستخلصة من اللغات الغنية بالبيانات إلى لغات لا تتوافر لها مواد تدريبية واسعة.
وتحاول غوغل أيضًا معالجة مشكلة نقص البيانات من خلال شراكات محلية. ومن بين الأمثلة مجموعة بيانات صوتية تغطي 27 لغة أفريقية، ومشروع يجمع تسجيلات من 109 لغات في الهند، فضلًا عن مبادرة شارك فيها خبراء محليون وجامعات من قارات مختلفة لتوثيق الفروق المرتبطة بالنطق والسياق والعادات اللغوية.
ويمتد التركيز إلى المناطق التي تعاني ضعف الاتصال بالإنترنت. فقد طوّرت الشركة نماذج ترجمة خفيفة يمكن تشغيلها على الجهاز مباشرة، كما دعمت تجربة مساعد صوتي يعمل عبر الهواتف التقليدية في رواندا، ما يتيح الوصول إلى خدمات الذكاء الاصطناعي من دون الاعتماد الكامل على الهواتف الذكية أو الاتصال المستمر بالسحابة.
وتشمل الرؤية المعلنة جانبًا متعلقًا بإتاحة الاستخدام لذوي الإعاقة. فغوغل تعمل على تقنيات لتحويل لغة الإشارة إلى نص، مع تدريب على أكثر من 50 لغة إشارة، وبدأت تطبيقات أولية باللغة الإشارة الأمريكية إلى الإنجليزية في بعض خدمات الكتابة والترجمة الفورية.
وتبرز المبادرات المحلية كذلك في تفاصيل تبدو صغيرة لكنها مؤثرة، مثل تحسين نطق أسماء الأماكن. وتشير غوغل إلى تعاونها مع خبراء اللغة الماورية في نيوزيلندا لإدخال نطق أكثر دقة لأسماء المدن والشوارع، في محاولة لربط أدوات الصوت والسياحة والملاحة بالسياق الثقافي للمجتمعات المعنية.
وتعكس هذه الخطوة تحولًا في تعريف جودة الترجمة والاعتراف الصوتي. فالمعيار لم يعد إنتاج جملة صحيحة نحويًا فقط، بل فهم ما يقصده المتحدث وطريقة قوله والبيئة الثقافية التي ينتمي إليها. غير أن نجاح هذا التوجه سيظل مرتبطًا بجودة البيانات المحلية، وبمدى مشاركة المجتمعات في تحديد كيفية تمثيل لغاتها وحمايتها من التبسيط أو سوء الفهم.
وبحسب الخطط المعلنة، ستواصل غوغل توسيع أدواتها اللغوية عبر خدمات البحث وأندرويد وكروم ويوتيوب ومنصة غوغل بلاي. ويبقى التحدي التالي هو تحويل النماذج البحثية والشراكات المفتوحة إلى ميزات متاحة على نطاق واسع، مع الحفاظ على الخصوصية ودقة الأداء وعدم جعل المستخدمين يتخلون عن خصائص لغاتهم كي تتوافق مع حدود التقنية.
العودة إلى جميع الأخبار